Как с Netflix Servo постигнахме с x2 по-бързo зареждане на мобилното ни приложение за потребителите в Азия
Един от основните проблеми, когато разработваш high performance and scalability software платформа, изградена от много micro services комуникиращи по различни шини по между си е как да познаваме системата си от вътре. Как да наблюдаваме приложенията, от които тя се състои и тяхното измеримо поведение под въздействието на потреблението на услугите, предоставени на нашите клиенти. Освен това как лесно, бързо и еднозначно да индетифицираме performance bottlenecks или грешно имплементирана логика и по-късното й отстраняване.
След бързо оценяване на възможните варианти идентифицирахме комбинацията Netflix Servo + Grafana, като перфектното решение което ни дава възможността за доста елегантно, бързо за имплементиране, лесно за усвояване и при това напълно безплатно решение:
- Пакетирахме Netflix Servo като библиотека, част от development infrastructure, която всяко Java приложение да добави бързо и лесно като dependency.
- Конфигурирахме библиотеката да предоставя статистики (jmx counters and stats, rps, latency, exceptions/sec) за Java приложенията агрегирани на 10 секундни периоди.
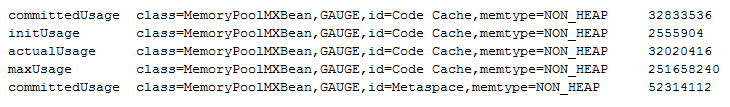
Netflix Servo Standard Output - Данните изпращаме към Carbonа , а за удобна визуализация ползваме Graphite или Grafana.
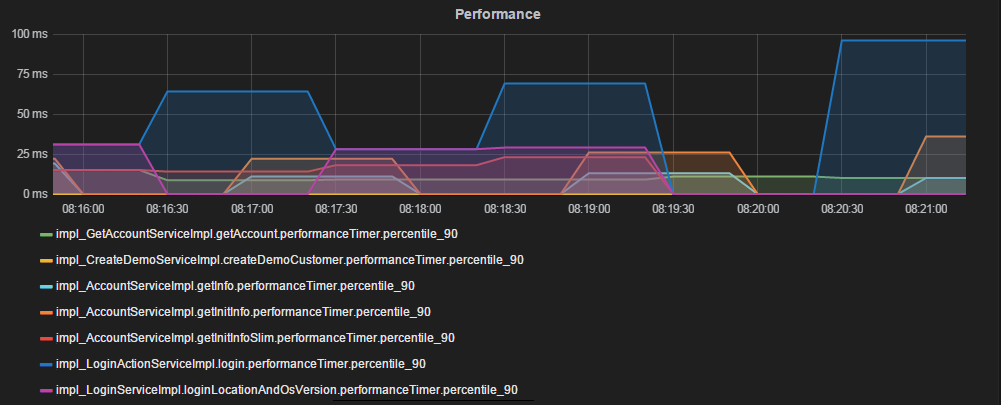
Grafana Custom Dashboard
Ето и конкретен пример:
Поради голямата отдалеченост и високата network latency между Европа и Азия, зареждането (времето от натискане на бутона логин до пълното изобразяване на обектите) в мобилното ни приложение отнема два пъти повече от нормално време за останалия свят.
След анализ на логовете видяхме, че всяко зареждане на мобилното приложение прави поредица от последователни заявки към сървърите ни, като времето за изпълнението на една от тях се открояваше рязко на фона на останалите.
Разбира се, отразихме че в nginx/request.logs влиза сървърното плюс времето за доставка, което пречеше да идентифицираме истинското състояние и генезиса на проблема.
Чрез инструментация на кода с Netflix Servo успяхме да декомпозираме всички тези заявки към сървъра по интерфейси и да видим колко точно е сървърното време. Вече беше лесно да идентифицираме, че всички заявки отнемат “X” сървърно време, а най-бавната съответно 0.8*Х, като ясно се виждаше, че времето започваше да се акумулира по всички нива от базата, бекенд, фронтенд до клиентите.
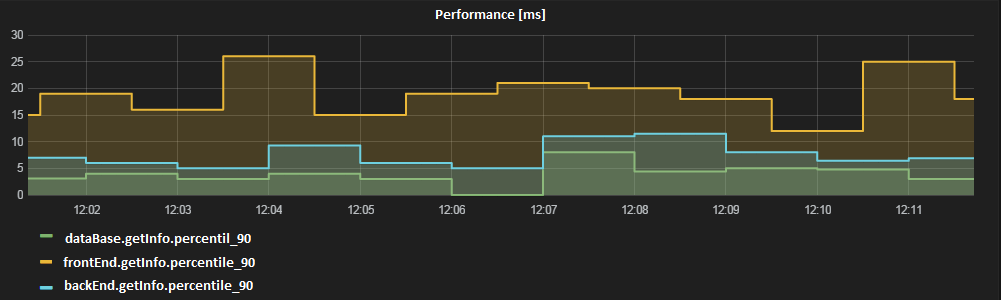
В същото време, сравнявайки броя на успешно завършилите операции (първите и последните заявки част) от зареждането на приложението, идващи от Европа и Азия, успяхме да открием, че в същност имаме не малко клиенти, които се отказват да чакат и прекъсват процедурата по регистрация на нов акаунт. Това ни наведе на мисълта, че проблема е по-скоро в големината на трансферирания пакет, а не в контейнерите или deadlocks. Бърза проверка показа, че заявката, която доставяме на клиента е с големина от 500 КБ и транспорта се случва на поредица от TCP/IP round trips, което съвсем обясняваше защо в далечните дестинации имаме отклонение от 100% спрямо европейските ни клиенти.
След като имахме пълната картинка на проблема, с малко промени в кода редуцирахме броя обекти, които връщаме до стриктния минимум нужен за логин, а останалите обекти да се изтеглят с отделена заявка само ако потребителя има нужда от това. С това намалихме размера до 120 КБ, сървърното време до 0.1*X, а времето за доставка до отдалечените дестинации спадна до 4 пъти.
Благодарение на тази проста оптимизация успяхме да редуцираме драстично (до 2 пъти) времето за зареждане на приложението, а като страничен ефект увеличихме и броя на успешно завършилите регистрации с 5%.
Не на последно място, Netflix Servo може да бъде успешно решение и за:
- анализ на клиентски проблеми – колко често клиента чете Новини в платформата или например използва smart market order widget-a.
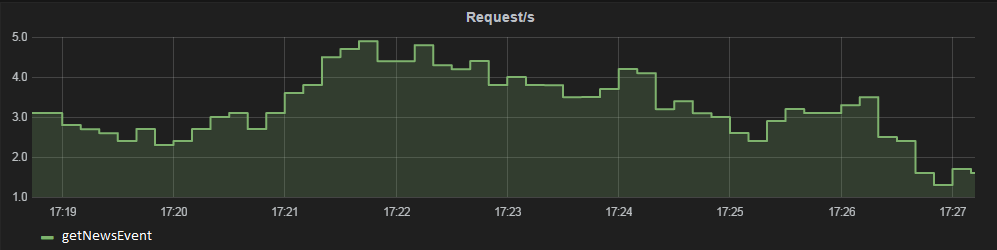
getNewsEvent Interface Distribution - установяване на performance проблеми при работа с външни provider-и.
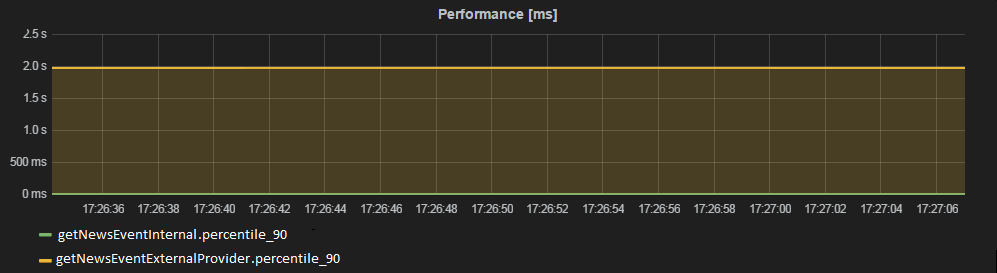
getNewsEvent Distribution